Domain gaunerei.de kaufen?
Wir ziehen mit dem Projekt
gaunerei.de um.
Sind Sie am Kauf der Domain
gaunerei.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain gaunerei.de kaufen?
Was ist der Unterschied zwischen List und Hinterlist?
Der Unterschied zwischen List und Hinterlist liegt in der Absicht und dem Vorgehen. List bezieht sich auf eine geschickte und kluge Vorgehensweise, um ein Ziel zu erreichen, während Hinterlist auf eine betrügerische und hinterhältige Vorgehensweise hinweist, bei der jemand absichtlich andere täuscht oder schädigt. List kann als positiv angesehen werden, während Hinterlist negativ konnotiert ist. **
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Herbert List. Panoptikum, Fachbücher von Herbert ListDie Publikation "Herbert List. Panoptikum" bietet einen tiefen Einblick in das faszinierende Werk des Fotografen Herbert List, der für seine einzigartigen Darstellungen von Wachsfiguren im Wiener Panoptikum bekannt ist. In diesem Bildband werden seine Fotografien von 1944 präsentiert, die die künstlichen Menschen in dramatischen Posen zeigen und sie als "aufgestellte, geschminkte Leichen" beschreiben. Der Band kombiniert Märchenszenen, historische Tableaux und medizinische Sujets und wird durch einen Kommentarband ergänzt, der List in den Kontext seines künstlerischen Schaffens und der Geschichte des Panoptikums einordnet. Diese bibliophile Ausgabe, die auf dem Originalentwurf basiert, ist eine Hommage an die Verbindung von Kunst, Wissenschaft und der menschlichen Faszination für das Ungewöhnliche. Die sorgfältige Aufbereitung und der feste Einband machen dieses Werk zu einem wertvollen Sammlerstück für Kunstliebhaber und Fotografie-Enthusiasten.54,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **

Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
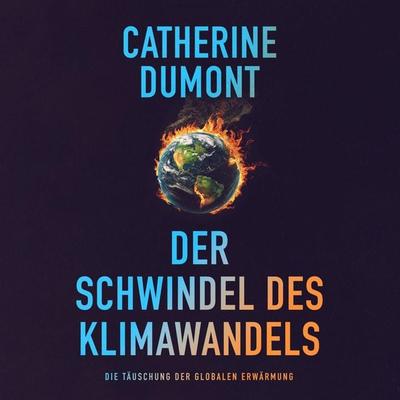
Der schwindel des klimawandels: Die täuschung der globalen erwärmung - Catherine Dumont, Audio, 4066004775661Der Schwindel Des Klimawandels: Die Täuschung Der Globalen Erwärmung Von Catherine Dumont, Cooltura, Sprecher: Edward Rumer, Sprache: Deutsch3,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen List und Hinterlist?
Der Unterschied zwischen List und Hinterlist liegt in der Absicht und dem Vorgehen. List bezieht sich auf eine geschickte und kluge Vorgehensweise, um ein Ziel zu erreichen, während Hinterlist auf eine betrügerische und hinterhältige Vorgehensweise hinweist, bei der jemand absichtlich andere täuscht oder schädigt. List kann als positiv angesehen werden, während Hinterlist negativ konnotiert ist. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Herbert List. Panoptikum, Fachbücher von Herbert ListDie Publikation "Herbert List. Panoptikum" bietet einen tiefen Einblick in das faszinierende Werk des Fotografen Herbert List, der für seine einzigartigen Darstellungen von Wachsfiguren im Wiener Panoptikum bekannt ist. In diesem Bildband werden seine Fotografien von 1944 präsentiert, die die künstlichen Menschen in dramatischen Posen zeigen und sie als "aufgestellte, geschminkte Leichen" beschreiben. Der Band kombiniert Märchenszenen, historische Tableaux und medizinische Sujets und wird durch einen Kommentarband ergänzt, der List in den Kontext seines künstlerischen Schaffens und der Geschichte des Panoptikums einordnet. Diese bibliophile Ausgabe, die auf dem Originalentwurf basiert, ist eine Hommage an die Verbindung von Kunst, Wissenschaft und der menschlichen Faszination für das Ungewöhnliche. Die sorgfältige Aufbereitung und der feste Einband machen dieses Werk zu einem wertvollen Sammlerstück für Kunstliebhaber und Fotografie-Enthusiasten.54,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Yaghoobifarah, Hengameh: SchwindelSchwindel , Roman , Elektromotorenteile > Elektromotoren & -teile , Erscheinungsjahr: 20240917, Produktform: Leinen, Autoren: Yaghoobifarah, Hengameh, Seitenzahl/Blattzahl: 240, Themenüberschrift: FICTION / LGBTQ+ / Transgender, Keyword: Begehren; Beziehungen; Dach; Feminismus; Gegenwartsliteratur; Großstadt; Habibitus; Hengameh Yaghoobifarah; Humor; LGBTQ; Liebe; Liebesroman; Liebhaberinnen; Ministerium der Träume; Polyamorie; Queerness; Roman; feministisch; rasant; urban; witzig; zeitgenössisch, Fachschema: Deutsche Belletristik / Roman, Erzählung, Fachkategorie: Zeitgenössische Liebesromane~Belletristik: Themen, Stoffe, Motive: Liebe und Beziehungen~Belletristik: Themen, Stoffe, Motive: Vielfalt, Gleichheit und Inklusion, Interesse Alter: Bezug zu Transgender Personen und Gruppen, Warengruppe: HC/Belletristik/Romane/Erzählungen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 210, Breite: 140, Höhe: 24, Gewicht: 334, Produktform: Gebunden, Genre: Belletristik,23,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.